投資 · 2026.10.10 · 3 min
預測利率尖峰、先留資金等高利?回測完我決定不做
我用完美預知的收益上限當門檻,再做樣本外回測,檢查預測放貸利率尖峰、先留資金等高利值不值得做,結果上限不小,只用當下資料的模型卻只剩約 10bp。
閱讀設定
預測利率尖峰、先把資金留著等高利再借出,回測完我決定不做。完美預知的收益上限不小,只預知 3 小時就有 +54 到 +129bp;但只用當下看得到的資料,樣本外最好的模型只剩 10bp 上下,實測期間甚至是負的。猜錯就空等,空等的成本把猜對的收益吃掉了。
預測尖峰、先留資金,是放貸策略常被提到的點子。我想知道它能不能減少資金被低利單卡住的情況。
資金卡住是真的,但沒想像中嚴重
我拿 bot 實際放出去的一萬七千筆左右 USD credit 來看。2 天期有 55.6% 的資本天,在借出期間碰過 1.5 倍以上的批次頂價,卡住的感覺不是錯覺。
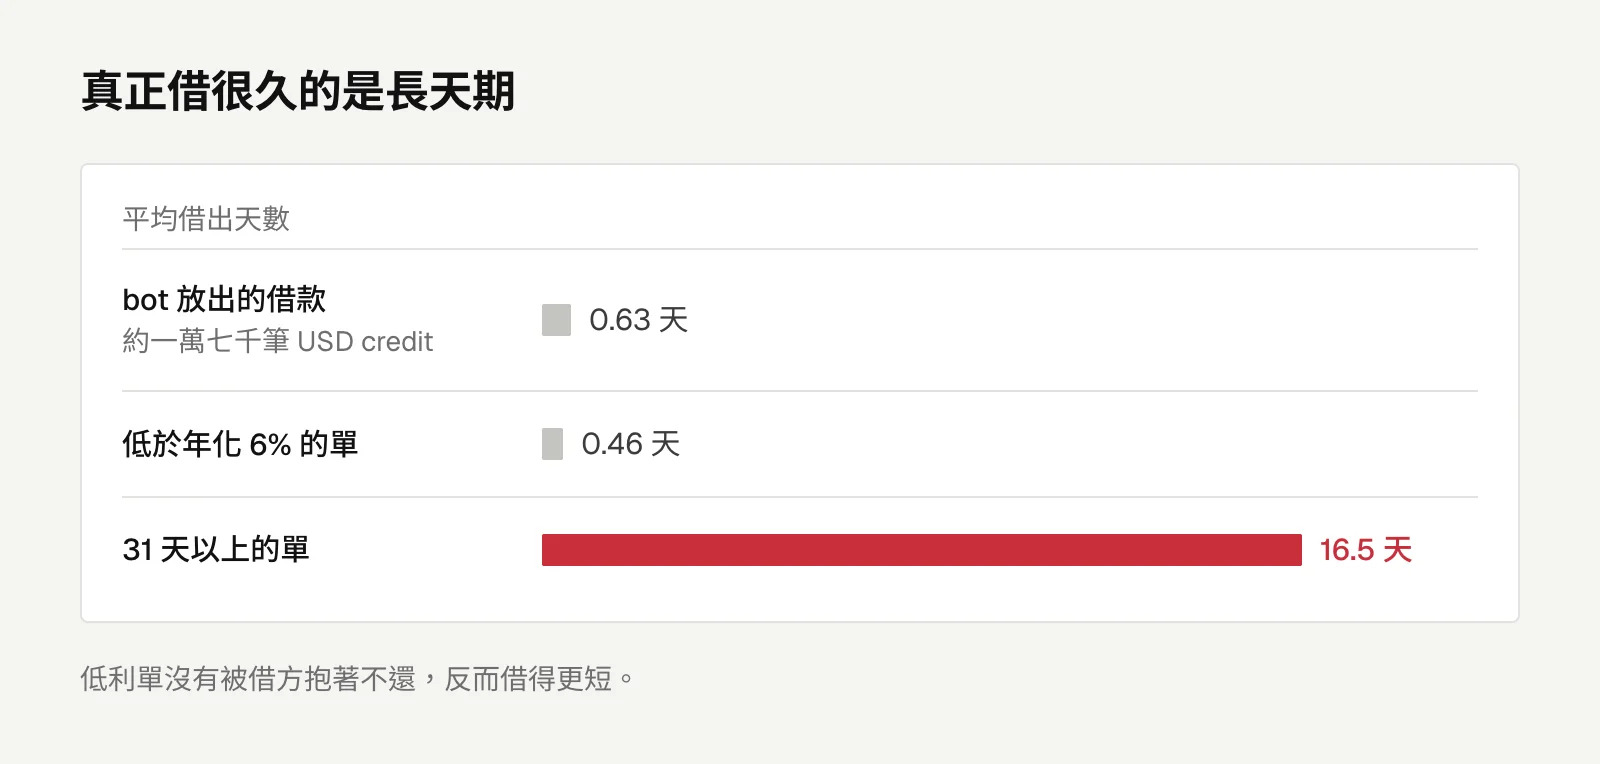
但這些借款平均只借 0.63 天就還了,低於年化 6% 的單反而借得更短,平均 0.46 天,沒有「低利單被借方抱著不還」這回事。6 月有 85% 的資本天低於 6%,那是全市場的利率都卡在同一道牆下,換什麼策略都一樣。真正會卡很久的是長天期,31 天以上的單平均借 16.5 天,那交給長天期 lane 的試跑去處理。
先算上限,再做樣本外
預測模型很容易做出看起來有用的東西,所以我先定門檻:先算完美預知的收益上限,上限太小就停;上限夠大才做樣本外驗證,兩年訓練、第三年測試,三年都要是正的,而且量級要大到實測量得出來。
回測沿用批次頂價尺的 harness,收益逐分鐘累計,尖峰價的 2 天單存續會打折,因為高利率時借方還得比較快。對照組是現行的 batch_top。
完美預知做了兩種。第一種一律等未來 H 小時內的最高點再掛,會把資金空等到部署率崩掉。第二種只在划算時才等:多拿到的利息乘上尖峰單的預期存續,要大於等待期間少賺的利息。後者才是公平的上限,因為它把等待成本算進去了。
真實模型用 logistic regression,特徵全是當下看得到的市況,例如近 24 小時高點相對於報價的比值、報價水位、幾個 VWAP 比值、時段。分數過門檻,就把一個 chunk 掛在 L 倍報價,最多等 H 小時,逾時回到原本的報價。H、L、門檻這些參數只在訓練年挑,第三年只負責報結果。
結果:上限不小,模型只剩 10bp
對 batch_top 的年化差,四個視窗依序是 2023-10 起一年、2024-10 起一年、最近一年、實測期間:
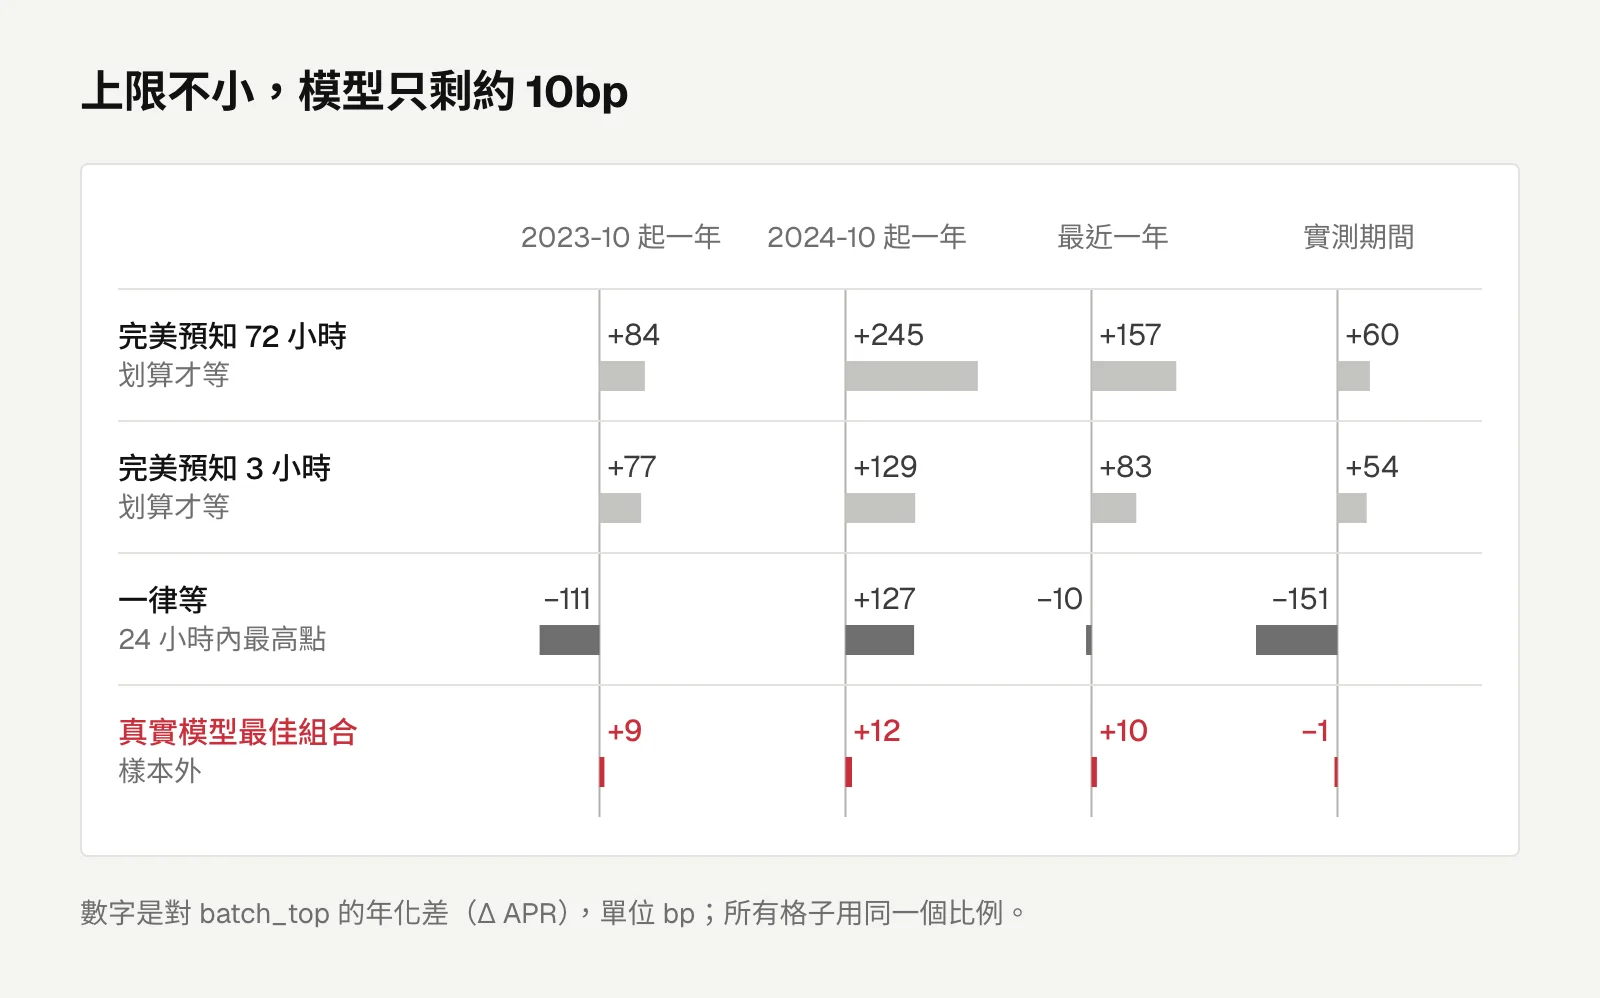
只預知 3 小時的版本,拿掉貢獻最大的兩個月還有 +32 到 +70bp,上限不是單一事件撐出來的。
真實模型的樣本外 AUC 有 0.64 到 0.87,單看會覺得不錯。最佳組合是預測 3 小時內會不會出現 1.5 倍的尖峰,改成預測 12 小時多數是負的。另外,某幾個 UTC 時段之後比較容易出現尖峰,兩段年份的相關係數高達 0.94,但單獨拿時段來預測,AUC 只有 0.54 到 0.57。
為什麼差這麼多
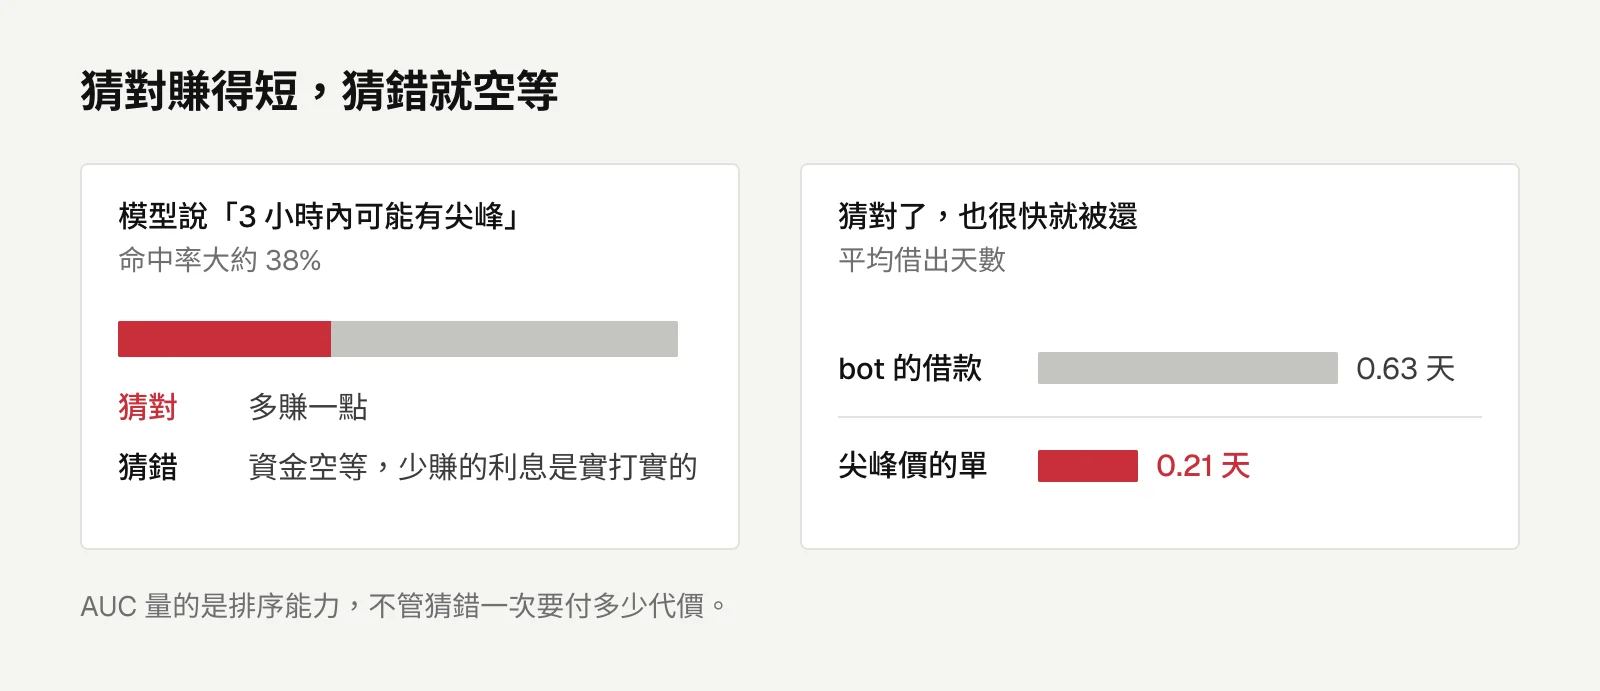
完美預知知道尖峰幾點來、有多高,模型只知道「3 小時內可能有」,命中率大約 38%。猜錯就空等,少賺的利息是實打實的;猜對的時候,尖峰價的單平均 0.21 天就被還了,多賺的那一點很快就結束。
模型的預測力主要來自「近 24 小時高點 ÷ 報價」這類均值回歸的訊號,而 batch_top 看最近幾批頂價的那把尺,本來就吃到這一塊了。模型能貢獻的只剩尺沒看到的部分,那部分很小。AUC 量的是排序能力,不管猜錯一次要付多少代價。
這個結論有前提:回測期間沒有持續數週的高利率行情,市場結構如果變了,例如批次拍賣消失,也要重看。
學到的事
- 做預測模型之前,先算完美預知的上限,上限決定這件事值不值得花時間。
- 上限要把等待成本算進去。一律等最高點聽起來是最強的預知,算進空等的成本反而會輸。
- 參數只在訓練期挑,測試期只報結果,樣本外的數字才有意義。
- 檢查新訊號之前,先問現有策略是不是已經吃到同一塊。
工程
自己寫一支模組依賴掃描器:架構圖加上進 CI 的分層規則
後端 18 個 package 之間有好幾組循環依賴,只靠人記。我寫了一支不用編譯的掃描器,產出能點進程式碼的架構圖、把分層規則放進 CI,同一天清掉 23 條既有違規,只有 2 條需要注入。
留言
載入留言中…