工程 · 2026.10.10 · 4 min
讓 Claude 分診告警但不給它改東西:唯讀分診的設計與踩坑
告警響了先讓只有唯讀工具的 Claude session 查根因、把結論貼到 Discord,這篇講權限邊界怎麼畫,以及模型改寫指令路徑、Sentry 噪音這兩個踩過的坑。
閱讀設定
告警響了,我先讓一個只有唯讀工具的 Claude session 去找線索、給結論、貼到 Discord,要不要改由我決定。「不能改東西」寫在 --allowedTools 裡,不靠 prompt 拜託。上線後踩過兩個坑:模型自己改寫指令路徑,被白名單連擋到放棄;Sentry 把會自己恢復的 WebSocket 斷線當成錯誤,每種例外各跑一次分診。分診的結論我只當線索,動手前自己再對一遍。
這個放貸平台最初的 exception 只留在 log,遇到白畫面或正式站異常,得 SSH 上機器 grep。後來補了三條觀測線:Prometheus、Grafana、Alertmanager 回答系統有沒有壞;Sentry 回答哪個使用者或路由遇到未處理的例外;Micrometer Tracing 加 OTLP 回答請求的時間花在哪裡。Sentry 在 DSN 空的時候前後端都不初始化,開了之後也關掉 sendDefaultPii、剝掉 query string,因為 cookie、API key、TOTP 這些不該進第三方的錯誤服務。分診就是把 Alertmanager 和 Sentry 的訊號統一後,交給 Claude 去查。
只診斷,不改東西
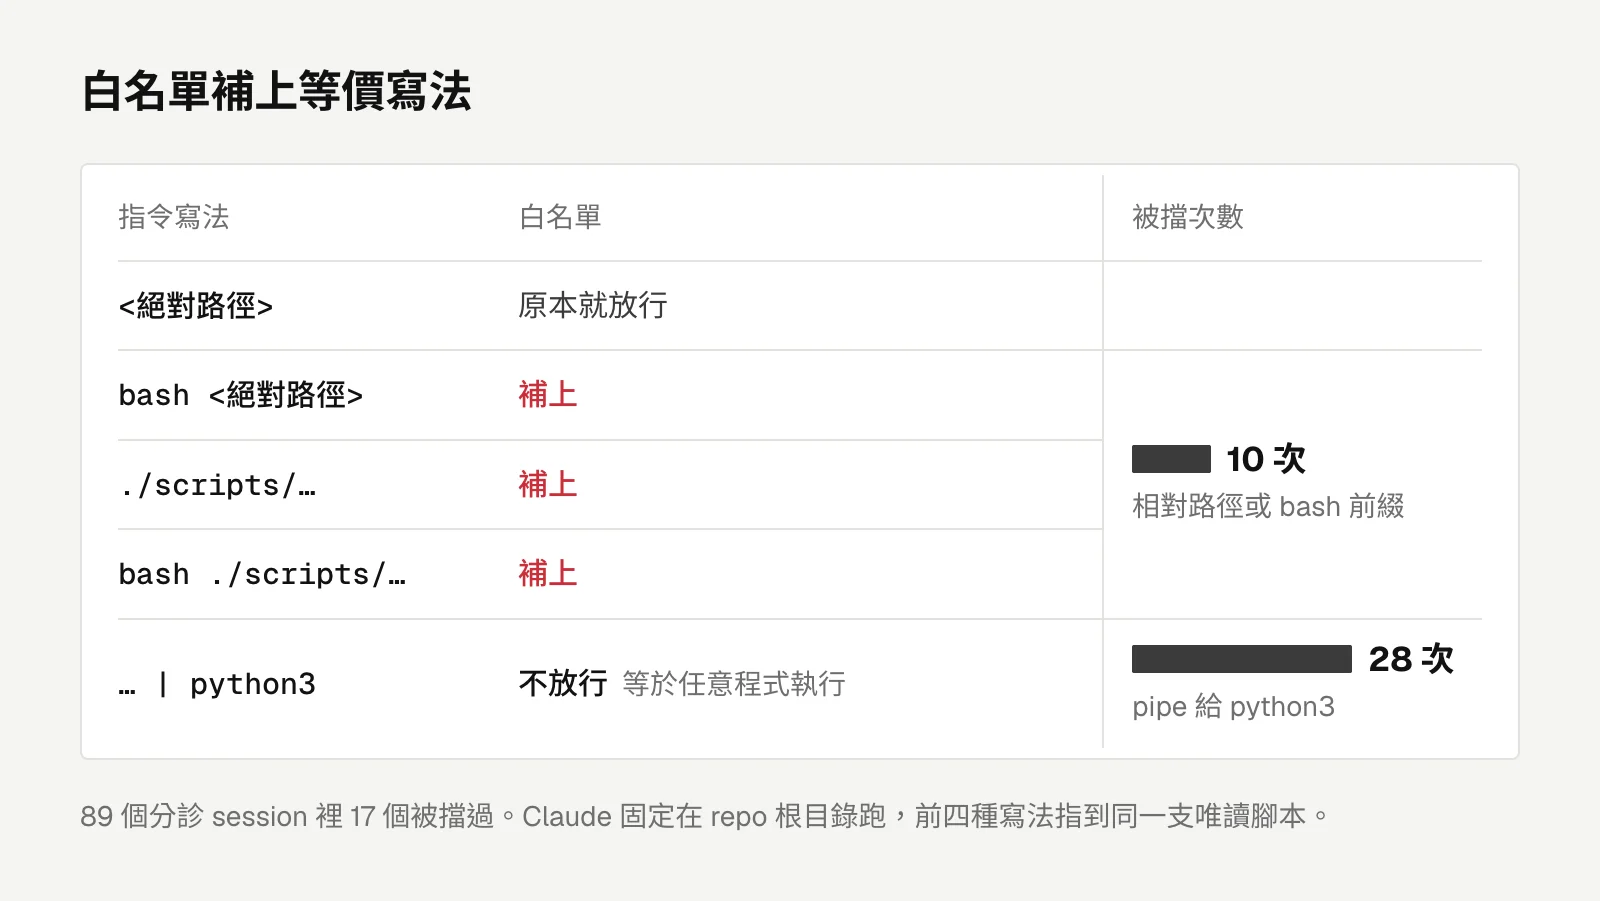
--allowedTools 只給 Read、Grep、Glob,加上一支唯讀的 ops 查詢腳本和 GitHub 查詢。沒有 Edit、沒有 Write、不能跑任意 Bash,這個 session 在機制上就動不了任何東西。
為什麼停在診斷?告警的根因可能是部署太密集把排程餓死,而不是 verifier 本身壞掉。一個能自動修的 agent,最可能做的事就是去改那支 verifier。分診把人留在「決定要不要改」這一步,這一步正好是機器最不可靠的地方。
每次分診都是真的 API 花費,所以同一個訊號 6 小時只查一次,每天最多 8 次,再用 mkdir 當鎖,一次只跑一個,後到的不排隊,因為排隊只會產出過時的結論。報告有固定格式,要給判定行;讀不到判定行就當成要修、開一張 issue,寧可多開一張。
一張只有一句話的 issue
有一天分診開了一張 issue,內文只有一句:「需要你授權才能跑這個指令」。
我去翻那台機器上那次 session 的 transcript。prompt 裡給的是查詢腳本的絕對路徑,模型卻改寫成 ./scripts/... 的相對路徑,再改成前面加 bash。白名單只認絕對路徑那一種寫法,連續被擋 5 次之後它就放棄了。放棄時那句話沒有判定行,照規則就開出了 issue。
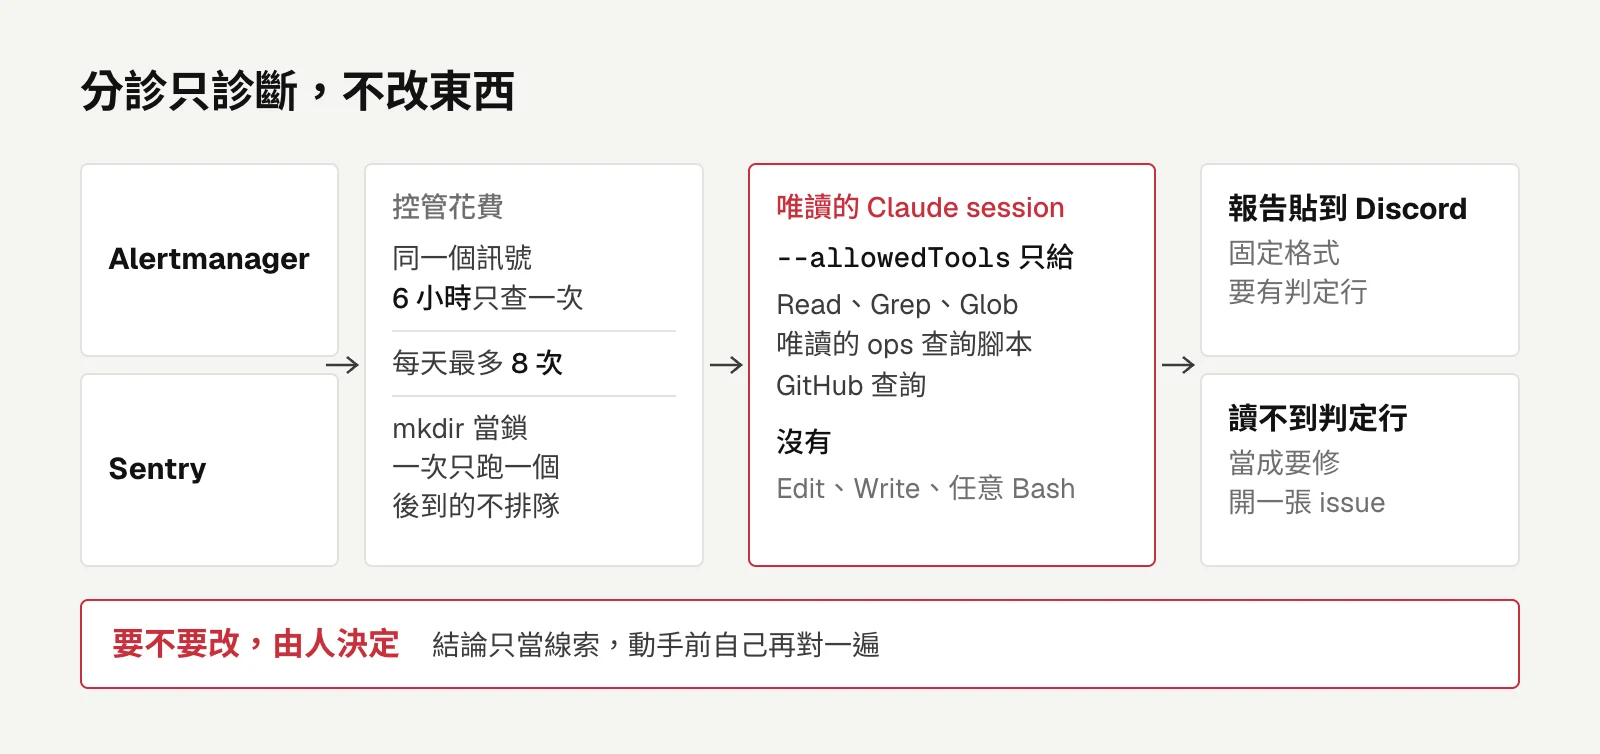
這不是個案。89 個分診 session 裡,17 個被擋過,其中 10 次是相對路徑或 bash 前綴,另外 28 次是把輸出 pipe 給 python3。
修法是白名單補上三種等價寫法:bash 加絕對路徑、./ 開頭的相對路徑、bash 加相對路徑。Claude 固定在 repo 根目錄跑,這幾種寫法指到的都是同一支唯讀腳本,能力沒有放寬。pipe 給 python3 則不放行,那等於開放任意程式執行。
prompt 也補了兩句:指令照給的路徑原樣打、不要 pipe;證據拿不到就照實寫在「問題」裡,仍然照固定格式給判定。我原本想寫「被擋就重打、不要要求授權」,結果 Claude Code auto mode 的分類器把這句判成 instruction poisoning 擋下來。回頭看也合理,叫一個 agent 被擋了別問人,看起來確實像在教它繞過權限。
源頭降噪
觸發那張 issue 的,是一次連 Bitfinex 的網路抖動:REST 先 timeout,WebSocket 斷線,重連又 timeout 一次,前後 30 秒就連回來了。
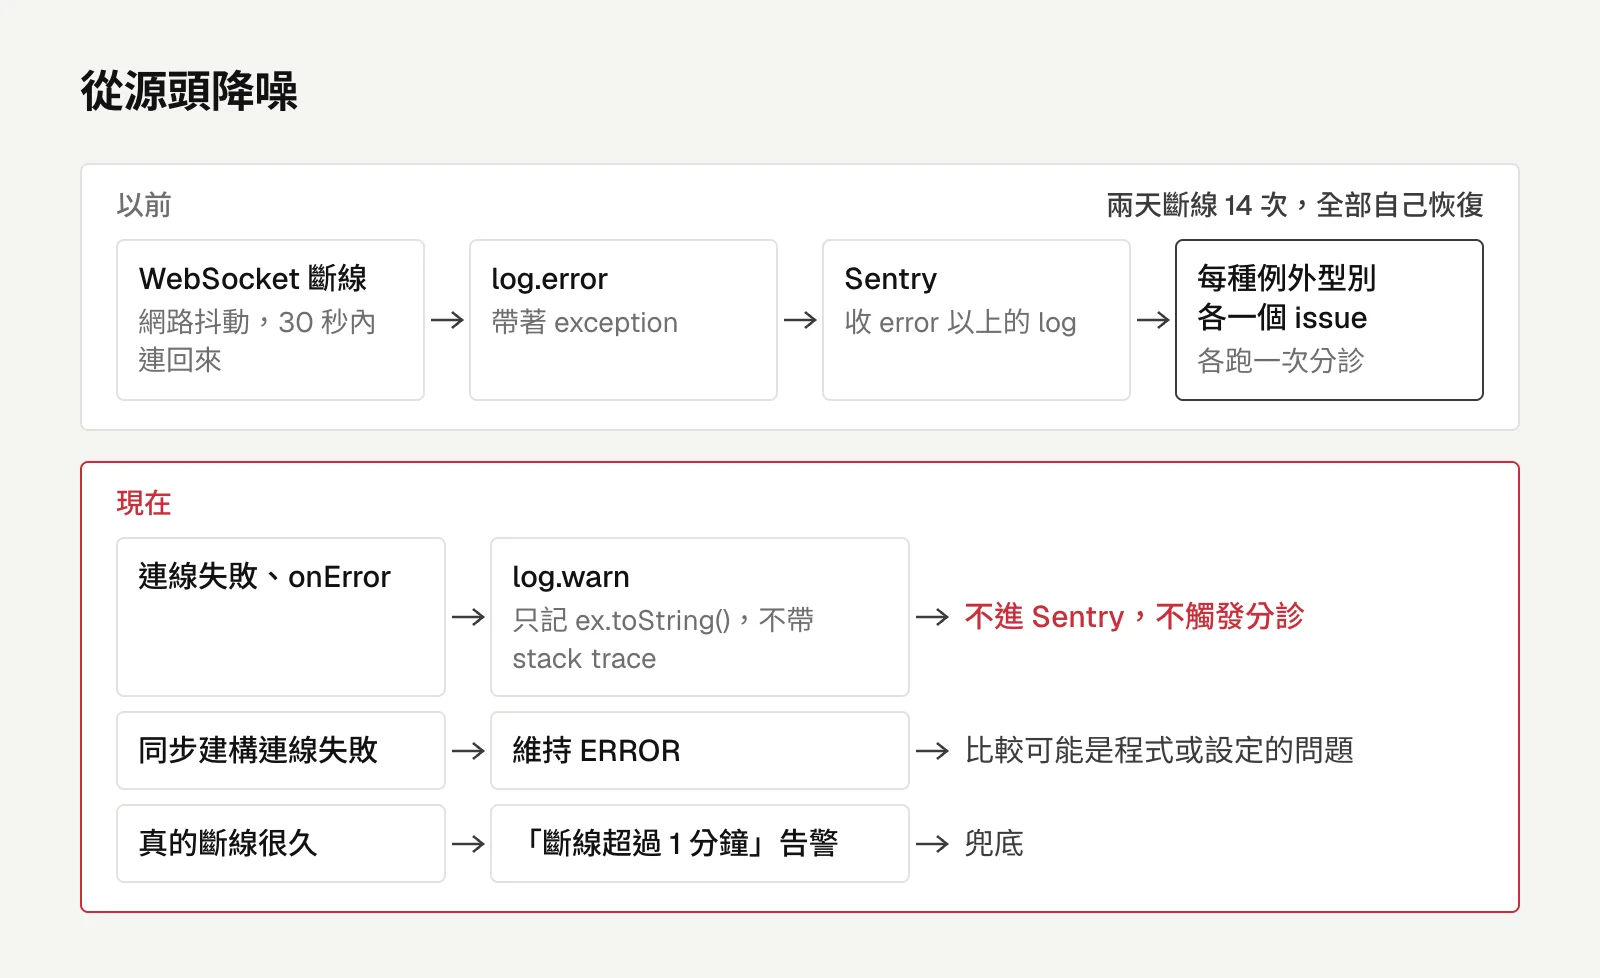
WebSocket client 在連線失敗與 onError 時用 log.error 帶著 exception 記錄,Sentry 又收 error 以上的 log,所以每一種網路例外型別都各開一個 Sentry issue、各跑一次分診。兩天內 WebSocket 斷了 14 次,全部自己恢復。
修法是把這兩處降成 log.warn,只記 ex.toString(),不帶全是 JDK 內部 frame 的 stack trace。同步建構連線失敗的那一行維持 ERROR,那比較可能是程式或設定的問題。真的斷線很久,還有「斷線超過 1 分鐘」的告警兜底。我沒有選擇在 Sentry 逐個 issue 設 ignore,因為新的例外型別(SSL handshake、DNS)會一直冒出新 issue,每一個都要燒一次分診。
新白名單還要等下次模型又改寫路徑才驗證得到,pipe 給 python3 被擋的情況也沒處理,分診仍可能查不完整。
結論只當線索
後來對帳告警響過兩次,分診的報告兩次都不對。第一次它猜對了是哪條新 lane 出問題,猜錯了哪裡算錯;第二次連哪裡壞都猜錯了。照著它的建議改,兩次都會改到沒壞的地方。追查過程寫在另一篇對帳的文章裡。
分診結論看起來不對時,我的第一步是去翻那次 session 的 transcript。每一次 tool call、每一次被擋的原因都在裡面,比猜 prompt 哪裡寫錯快很多。
學到的事
- 「不能改東西」要寫在權限裡,不要寫在 prompt 裡。模型會改寫指令,但改寫不出它沒有的工具。
- 白名單要涵蓋同一個能力的等價寫法,但每補一種都要問:這有沒有放寬能力?
- 寫給 agent 的 prompt,描述正確做法,不要教它怎麼繞過阻擋。
- 降噪從源頭做。暫時性的錯誤用 warn,持續性的狀態交給告警。
工程
AI 每 300ms 在鏈上掛一張單:gas 成本與保證金記帳的實測
把 Monad 上的 AI 交易展示專案拿去主網實盤,量到每個 block 重掛的 gas 比能賺的價差大十倍,也修掉一個讓 83% 到 95% 掛單被退回的保證金記帳 bug。
留言
載入留言中…