工程 · 2026.10.10 · 4 min
爬蟲只看到 spinner:Next.js 靜態站的預渲染與索引修正
EZLO 官網預渲染出來的 HTML 只有 spinner,Google 只認得英文版。改成依網址決定語言的預渲染,再修掉 robots.txt 造成的兩個索引問題。
閱讀設定
EZLO 官網是 Next.js 靜態匯出,我一直以為這樣就有預渲染。盤點才發現每一頁的 HTML 裡只有一個 spinner,文案全在 JS 裡,Google 補跑 JS 時看到的是英文版。我把公開頁改成依網址決定語言,build 時就把文案寫進 HTML。一週後 Search Console 報 36 個未建立索引,逐項看完,是 bug 的只有兩件,都出在 robots.txt。
EZLO 是我自己做的 Bitfinex 自動放貸 SaaS,前端放在 Cloudflare Pages,客群在台灣。
靜態匯出不等於有預渲染
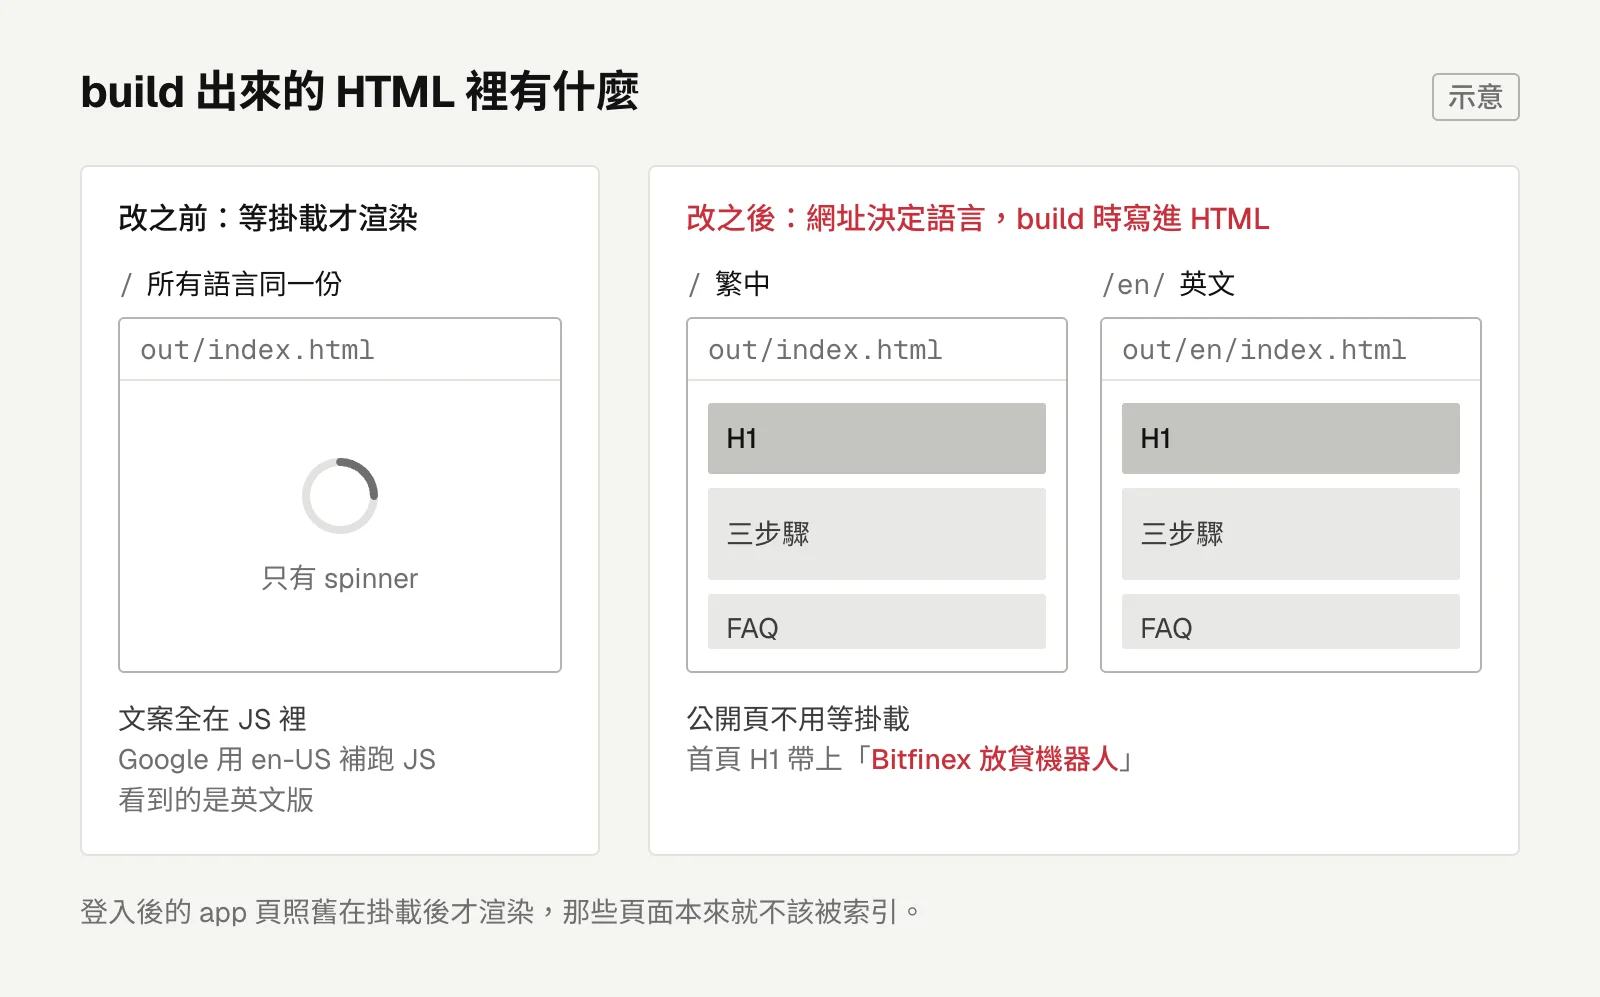
整個站包在一個 I18nProvider 裡,它要等瀏覽器掛載、偵測完語言才渲染子元件,所以 build 出來的 HTML 沒有任何文案。Google 渲染時用 en-US 環境,<html lang="en">、title 和分享圖也都是英文。客群搜尋用繁中,Google 眼中的 EZLO 卻是一個英文網站。
內容也有問題。品牌詞「EZLO」被同名的智慧家庭品牌佔滿,能拿流量的只有「Bitfinex 放貸機器人」這類品類詞,首頁 H1 裡卻沒有這些詞。
語言改由網址決定
繁中放在 /,英文放在 /en/。我加了一個 src/i18n/site.ts 依路徑判斷語言,為每個語系建立固定語言、同步初始化的 i18next instance。公開頁不用等掛載,文案在 build 時就寫進 HTML。登入後的 app 頁照舊掛載後才渲染,那些頁面本來就不該被索引。
改完打開 out/index.html,看得到 H1、三步驟和 FAQ,out/en/index.html 是英文。首頁 H1 也順手帶上「Bitfinex 放貸機器人」。
我想過用多個 root layout 分語系,讓每個語系有自己的 <html lang>。但 404 頁要改用實驗性的 global-not-found,static export 下沒驗證過。Google 判斷語言主要看頁面內容,單一 root layout 夠用。
metadata 有兩條規則。結構化資料只放站上真的有的東西,沒有真實評價就不放評分。價格不寫進 title 或 JSON-LD,價格的唯一來源是 DB,寫死在 meta 裡遲早過期。
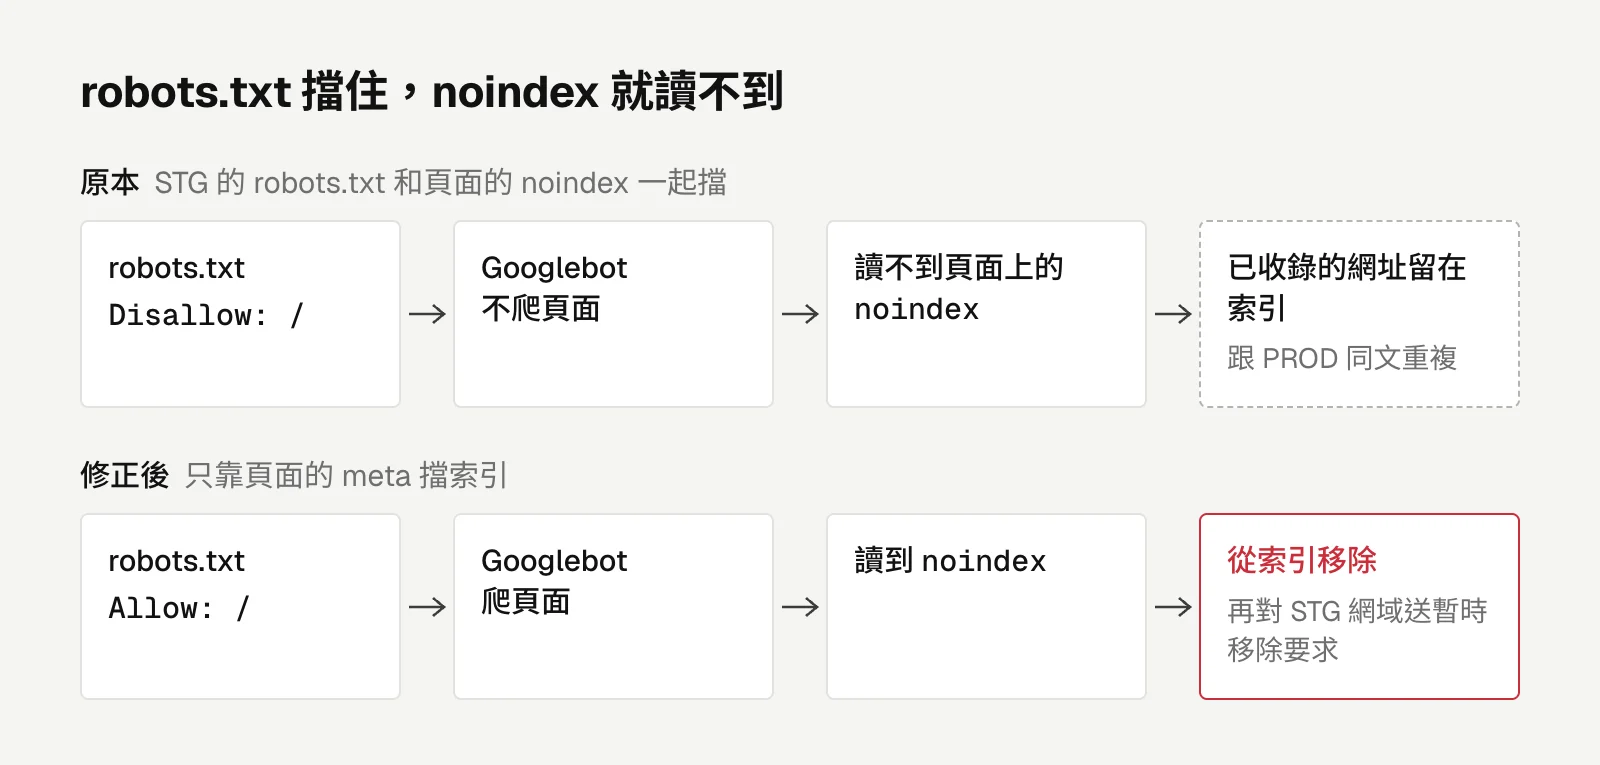
STG 和 PR preview 跟 PROD 跑同一份程式,不能被索引。我沒有另外加環境變數,直接看 NEXT_PUBLIC_API_URL 是不是 PROD 的 API。多一個 env var 就多一個漏設的機會,PROD 要是漏設,整站會變成 noindex,而且不會有任何錯誤提醒。非索引環境的頁面帶 noindex, nofollow,robots.txt 當時也設成 Disallow: /,問題就出在這裡。
一週後的兩個 bug
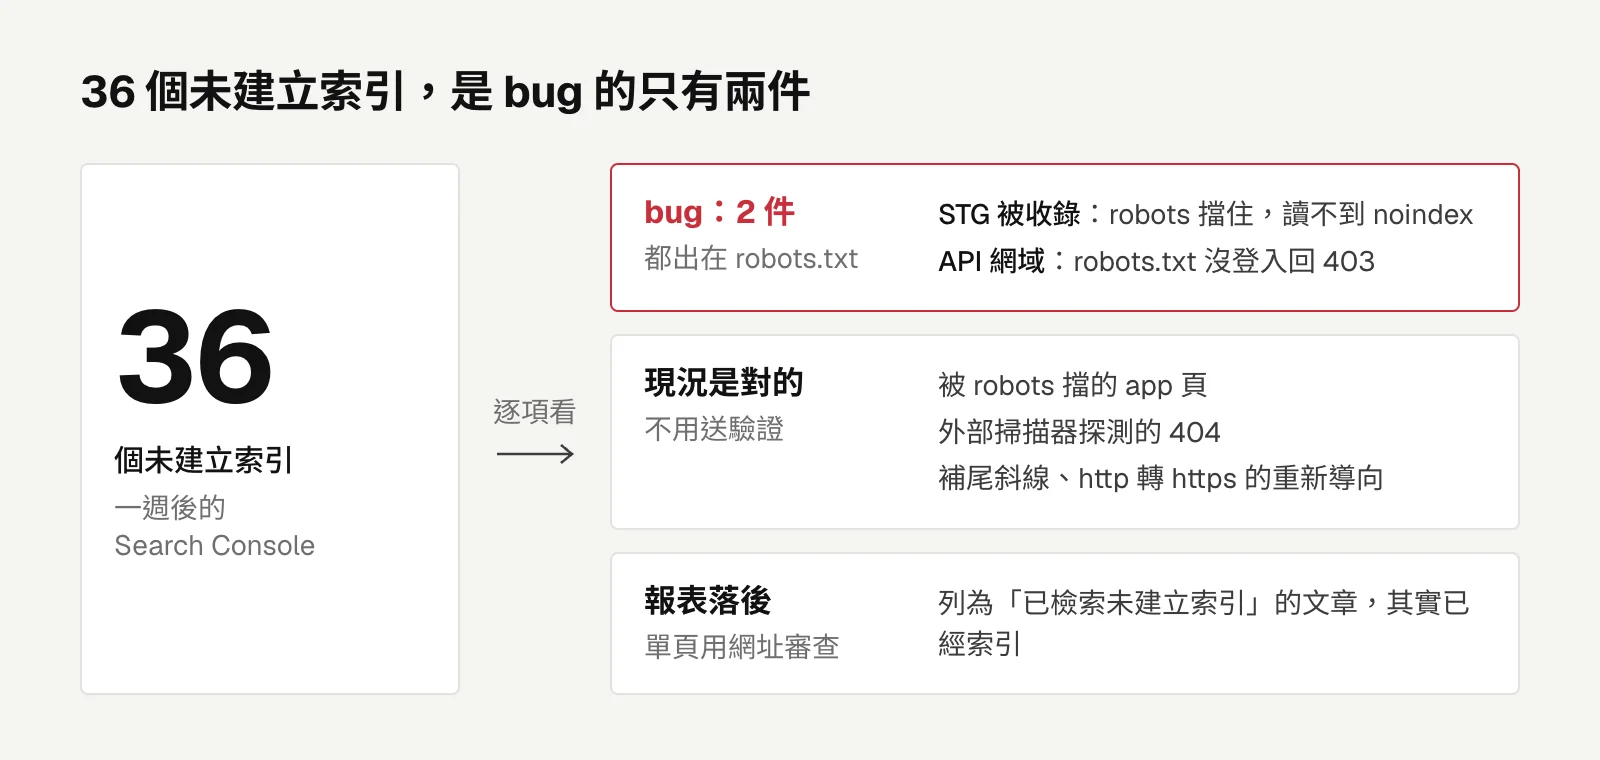
第一件是 STG 被收錄了,首頁、說明頁、活動頁都進了索引,跟 PROD 同文重複。
原因是兩個設定互相打架。robots.txt 寫 Disallow: /,Googlebot 就不爬頁面;不爬頁面,就讀不到頁面上的 noindex。已經進索引的網址,Google 沒機會知道它該被移除。Google 建議的除名路徑剛好相反,要讓爬蟲讀得到 noindex。所以 STG 的 robots.txt 改成 Allow: /,只靠頁面的 meta 擋索引,再對 STG 網域送暫時移除要求。
第二件是 API 網域。後端的 /robots.txt 沒登入就被 Spring Security 擋下來回 403。Google 把「robots.txt 取不到」當成整個網域被擋,PROD 和 STG 的 API 網域一直掛在「因拒絕存取 (403) 而遭到封鎖」。
修法是後端補一個回 Disallow: / 的 robots.txt,路徑放進 permitAll,也放進維護模式的放行清單。維護期間 robots.txt 回 5xx 比 403 更糟,Google 會直接把整個網域當成禁止檢索。API root 維持 403,它沒有要被索引的內容,robots 擋掉就是正確的結束狀態。
Search Console 要怎麼讀
報表落後好幾天,不能當現況看。報表寫「已檢索未建立索引」的幾篇文章,我逐篇做網址審查,其實都已經索引了。判斷單頁狀態要用網址審查,不要看彙總數字。
也不是每一項都要送驗證。被 robots 擋的 app 頁本來就要擋,外部掃描器探測的 404 本來就該是 404,補尾斜線和 http 轉 https 是正常的重新導向。這些現況是對的,送了只會拿到失敗。
還有一個 Cloudflare 的坑。英文首頁有一陣子顯示「已建立索引,但遭到 robots.txt 封鎖」,線上的 robots.txt 明明允許。往回查,有段期間 Cloudflare 的 Managed robots.txt 在檔案前面加了 Content Signals 註解和一段 AI bot 規則。這個功能現在還開著,之後只要動 AI bot 的偏好設定,Cloudflare 就會再改寫一次。
帶得走的幾件事
- 靜態匯出不保證內容有預渲染,build 完要打開 HTML 看。
- robots.txt 的 Disallow 和頁面的 noindex 不能拿來擋同一個網址,robots 擋了,noindex 就讀不到。
- robots.txt 本身要匿名回 200,403 和 5xx 都會被當成整個網域封鎖。
- 判斷環境能不能被索引,用 PROD 本來就必須設對的值,不要多開一個容易漏設的開關。
- Search Console 的彙總報表會落後,判斷單頁用網址審查。
工程
自動按掉 muse 的審批卡:從全部允許到信任清單
muse.ai 的 AI 助理遇到新網站就跳審批卡,排程任務常卡在半夜沒人按。我寫了 Chrome 擴充功能自動按允許,上架給別人用之後改成信任清單,並把發文這類收不回來的動作分開處理。
留言
載入留言中…